⚡ 30 秒总览
RAG(Retrieval Augmented Generation,检索增强生成)是目前最常用的 AI 问答方案之一。它的核心思想是:先从知识库中检索相关内容,再基于这些内容生成答案——即"先检索,再生成"。
🗺️ 学习地图
本视频从使用场景出发,逐步拆解 RAG 的每个环节,最后从"提问前"和"提问后"两个角度复习整个链路。
💡 为什么需要 RAG?
假设你想做一个智能客服来回答公司产品相关问题。最直接的做法是把产品手册全部发给大模型——但这行不通:
RAG 的解决思路:不把所有内容都发给模型,而是只检索与问题相关的片段,再把这些片段和问题一起发给大模型。
🔑 核心概念详解
📐 向量 (Vector)
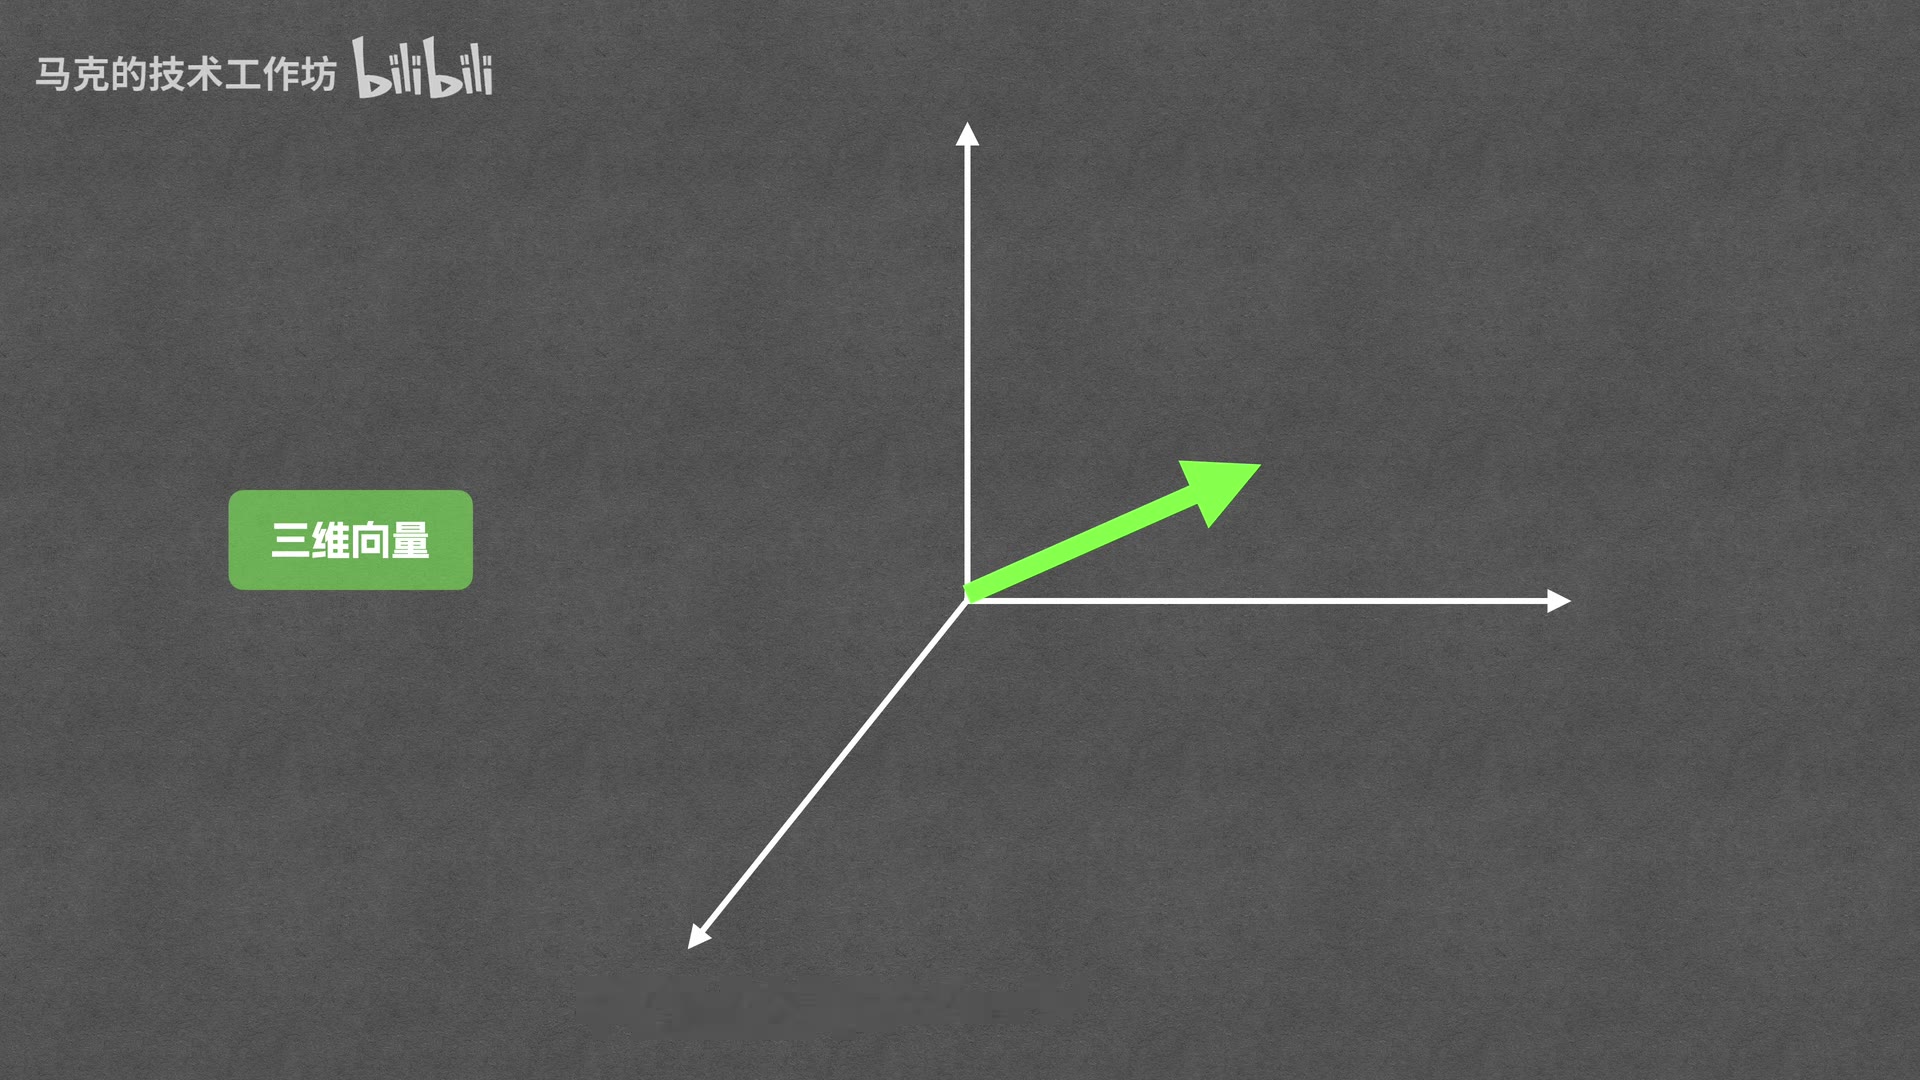
向量代表一个有大小、有方向的量,通常用一组数字表示。每个向量都有"维度",维度等于数字的个数。
- 一维向量:一个数字(如
[3]) - 二维向量:两个数字(如
[2, 2]) - 三维向量:三个数字(如
[1, 2, 3]) - RAG 中常用:几百到几千维,维度越大信息越丰富
🔄 Embedding(嵌入)
Embedding 是将文本转换为向量的过程。其核心目的是:含义相近的文本,转换后的向量也相近。
例如:
- "马克喜欢吃水果" → 向量
[1, 2] - "马克爱吃水果" → 向量
[1, 1](非常接近↑) - "天气真好" → 向量
[-3, -1](距离很远)
Embedding 由专门的 Embedding 模型完成(不是 GPT-4o、DeepSeek 这类模型),可参考 MTEB 排行榜选择最佳模型。
🗄️ 向量数据库
向量数据库是专门用来存储和查询向量的数据库,它做了很多优化,并提供计算向量相似度的函数。
存储时不仅要存向量,还要存原始文本——因为最终需要的是原始文本回答用户问题,向量只是中间结果。
🔍 RAG 完整流程拆解
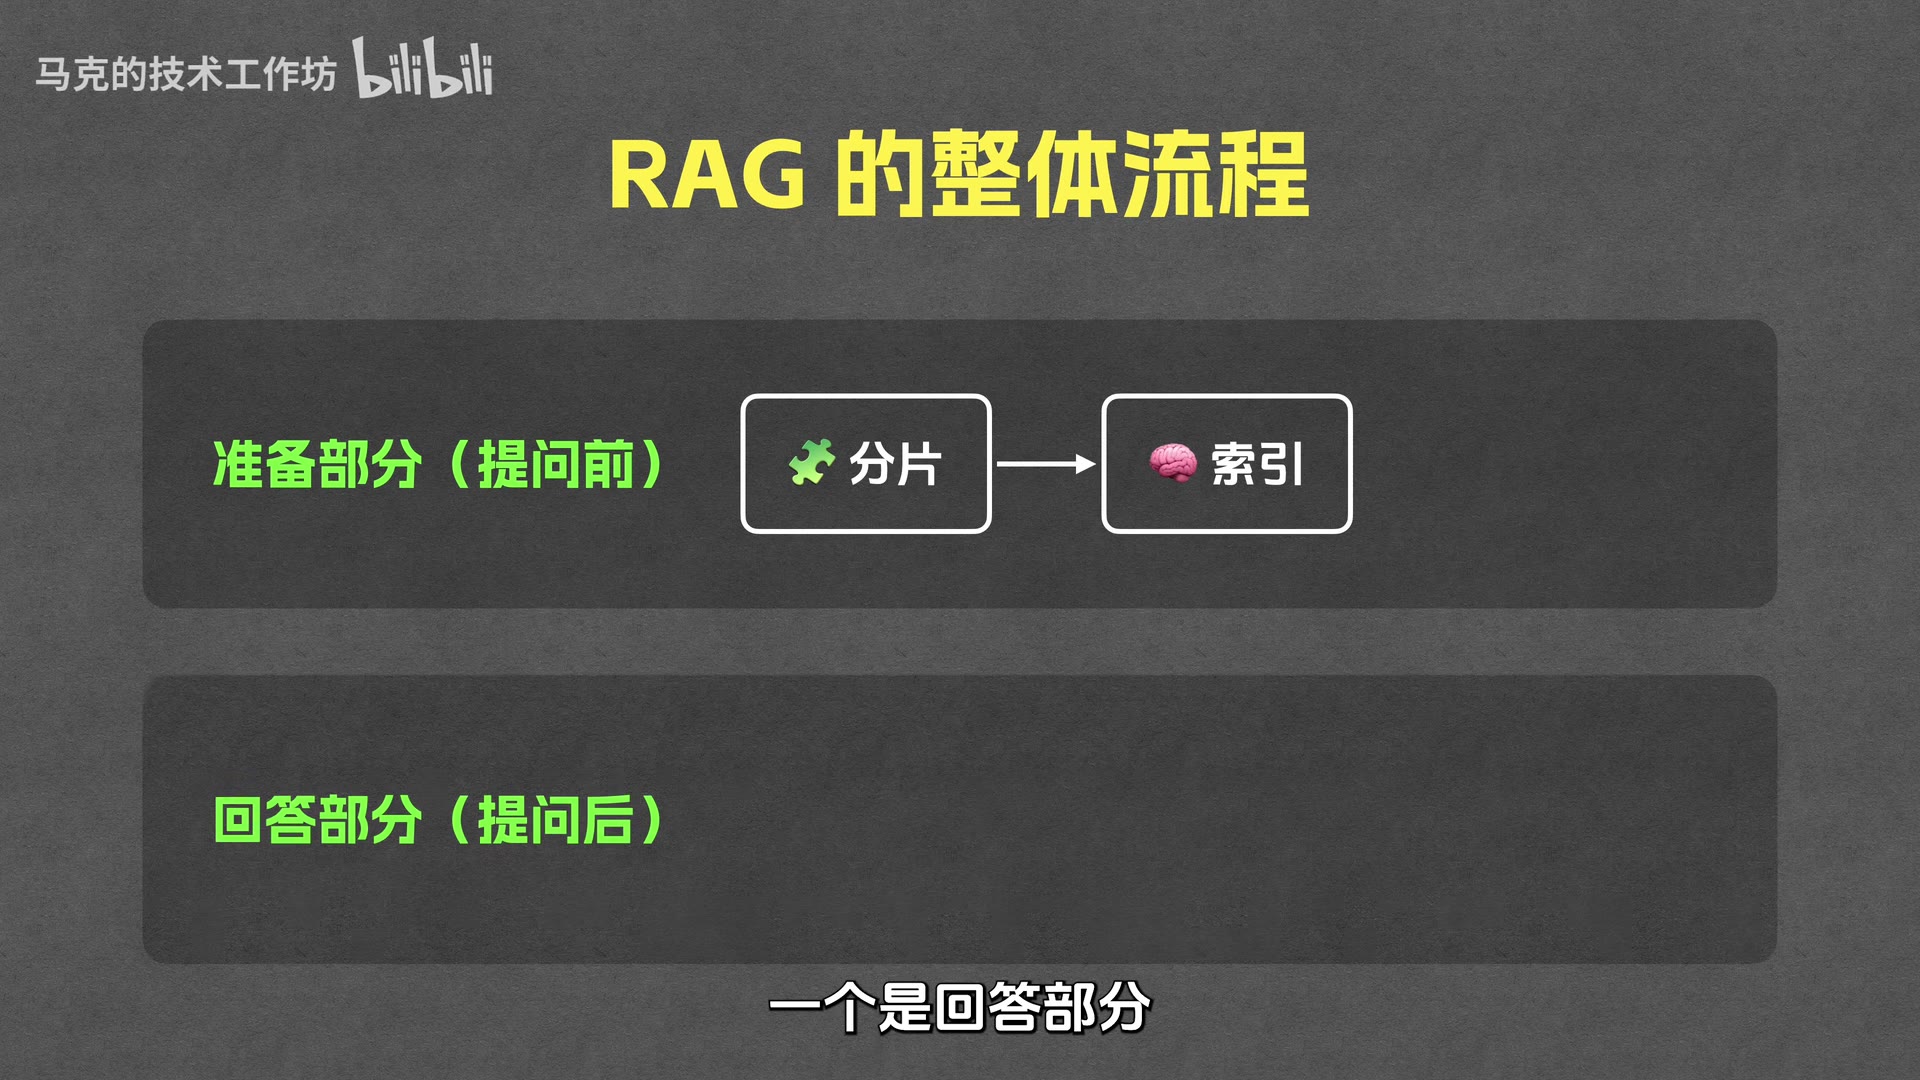
阶段一:数据准备(提问前)
① 分片 (Chunking)
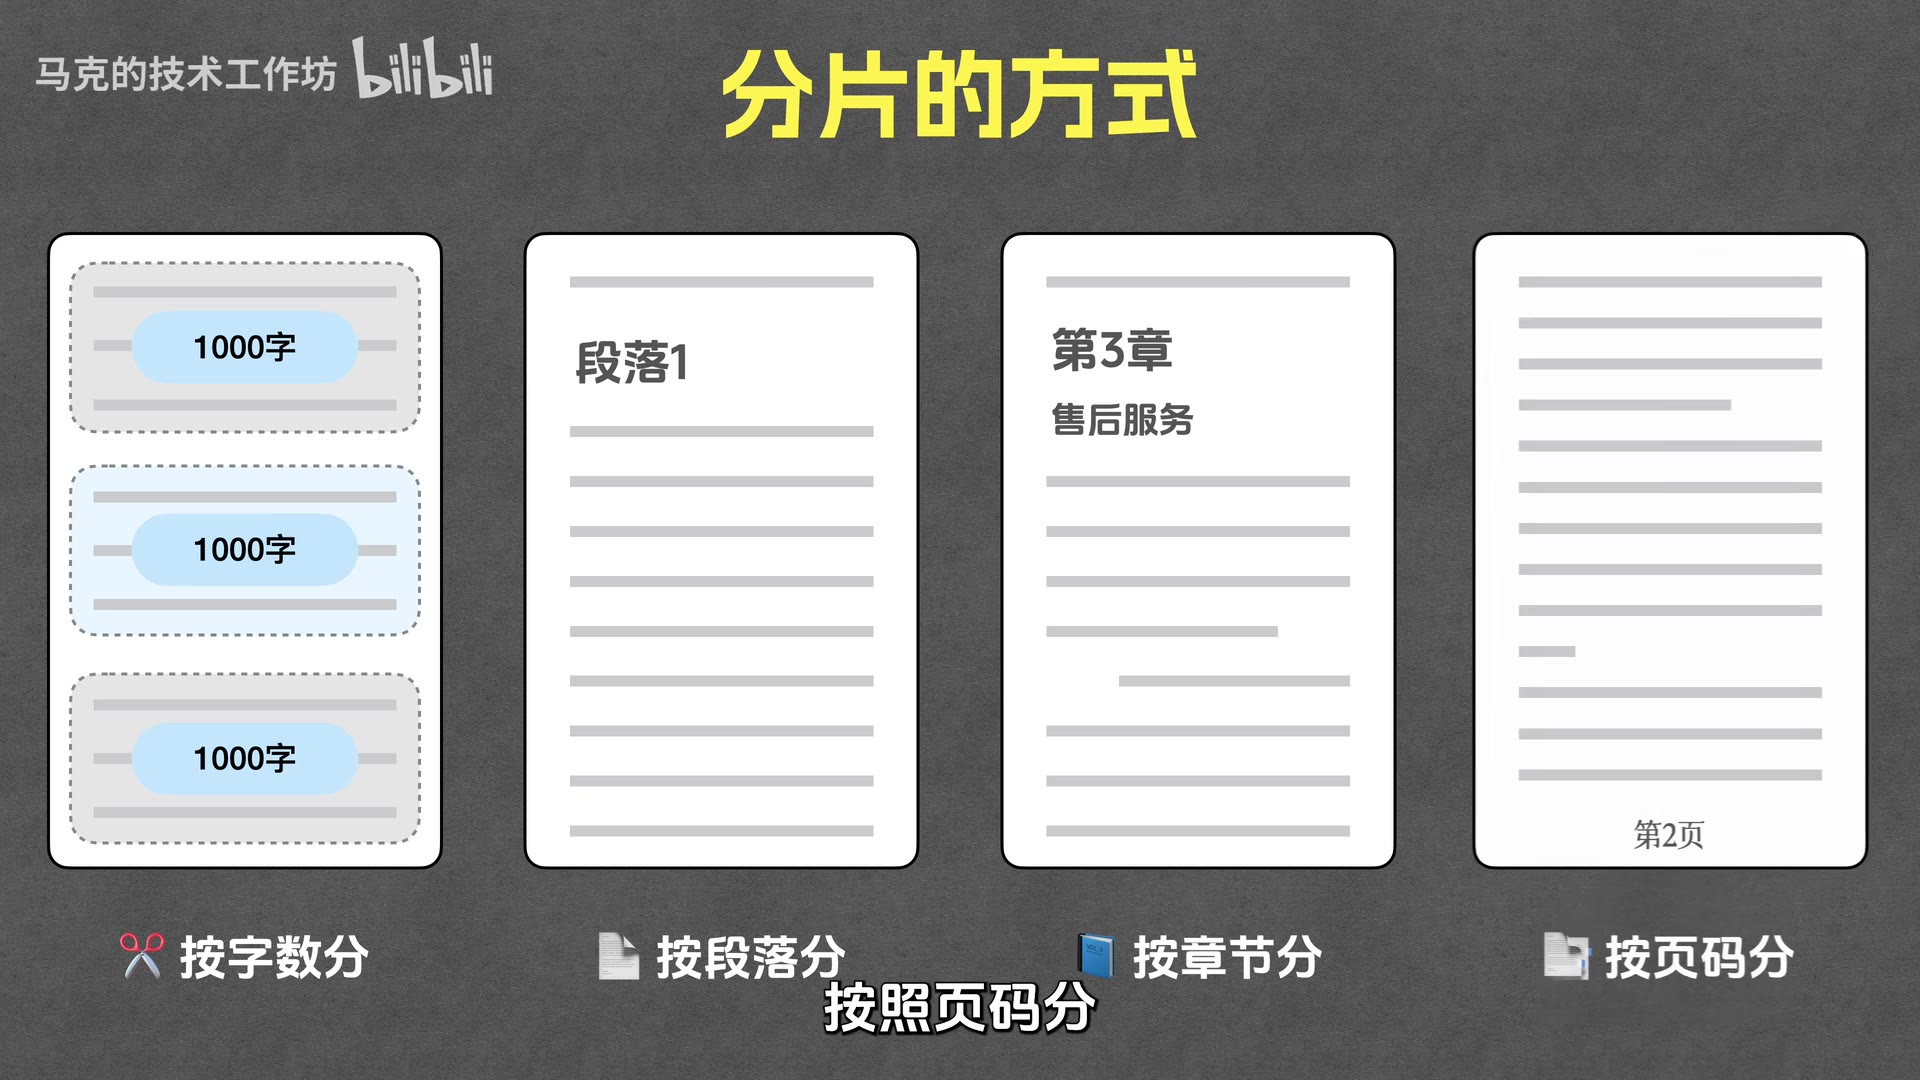
将文档切分为多个片段。方式有很多种:
- 按字数:如 1000 字一个片段
- 按段落:一个段落一个片段
- 按章节、按页码等
② 索引 (Indexing)
通过 Embedding 将每个片段文本转换为向量,然后将片段文本和对应向量都存储在向量数据库中。
过程:片段1 → Embedding → 存入数据库 → 片段2 → Embedding → 存入数据库 → ...直到所有片段处理完毕。
阶段二:回答(提问后)
③ 召回 (Retrieval)
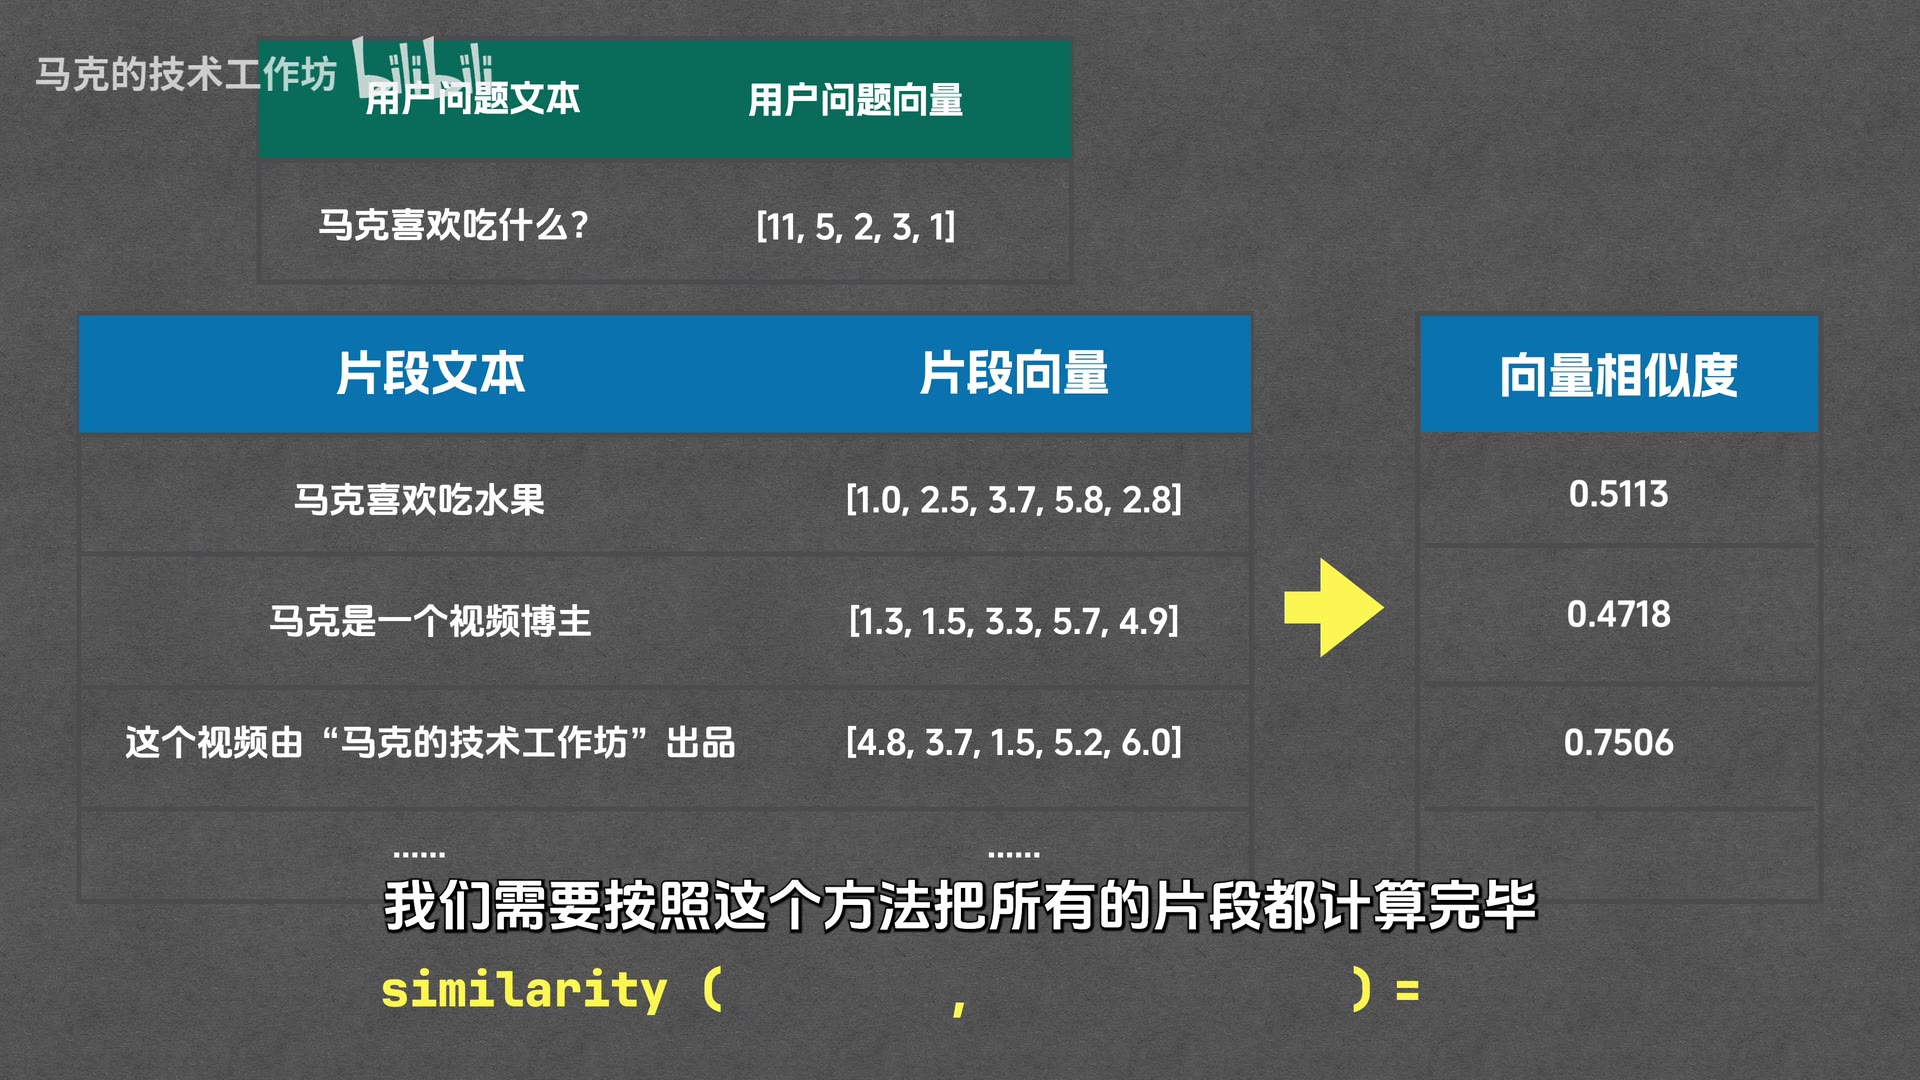
搜索与用户问题相关片段的过程:
- 用户问题 → Embedding 模型 → 转为向量
- 向量 → 向量数据库 → 查询最相似的 Top 10 片段
- 通过计算向量相似度来确定相关性
📊 向量相似度计算方法
| 方法 | 原理 | 判断标准 |
|---|---|---|
| 余弦相似度 | 计算两个向量夹角的余弦值 | 夹角越小 → 相似度越高 |
| 欧氏距离 | 计算两个向量之间的直线距离 | 距离越小 → 相似度越高 |
| 点积 | 考虑方向关系和长度的乘积 | 值越大 → 相似度越高;方向相反为负;垂直为0 |
④ 重排 (Reranking)
从召回的 10 个片段中,再精选出 3 个与问题最相关的。
为什么不直接在召回阶段就挑 3 个?因为两个阶段使用的方法不同:
| 对比维度 | 召回 (Retrieval) | 重排 (Reranking) |
|---|---|---|
| 方法 | 向量相似度(余弦/欧氏/点积) | Cross-Encoder 模型 |
| 成本 | 低 | 高 |
| 耗时 | 短 | 长 |
| 准确率 | 较低 | 高很多 |
| 角色 | 粗筛(像简历筛选) | 精选(像面试) |
⑤ 生成 (Generation)
将重排后的 3 个最相关片段 + 用户问题一起发给大模型(如 GPT-4o、DeepSeek),让它根据片段内容来回答用户问题。
📅 视频时间线
❓ 复盘问题
✅ 行动清单
- 理解 RAG 的完整链路:分片 → 索引 → 召回 → 重排 → 生成
- 掌握三个核心概念:向量、Embedding、向量数据库
- 了解三种向量相似度计算方法:余弦相似度、欧氏距离、点积
- 理解"召回+重排"两阶段设计的原因:成本与准确率的平衡
- 查看 MTEB 排行榜,了解当前最佳 Embedding 模型
- 尝试使用 LangChain / LlamaIndex 等框架构建一个简单的 RAG 应用
- 思考:分片策略(按字数 vs 按段落 vs 按语义)对效果的影响
📖 术语表
| 术语 | 英文 | 解释 |
|---|---|---|
| RAG | Retrieval Augmented Generation | 检索增强生成,先检索再生成的 AI 问答方案 |
| 向量 | Vector / Embedding | 一组数字表示的有大小有方向的量 |
| 嵌入 | Embedding | 将文本转换为向量的过程 |
| 分片 | Chunking | 将文档切分为多个小片段 |
| 向量数据库 | Vector Database | 专门存储和查询向量的数据库 |
| 召回 | Retrieval | 从所有片段中粗筛出 Top K 相关片段 |
| 重排 | Reranking | 用更精确的模型从召回结果中精选 |
| Cross-Encoder | Cross-Encoder | 用于重排的高准确率模型 |
| 余弦相似度 | Cosine Similarity | 通过夹角余弦值衡量向量相似度 |
| 欧氏距离 | Euclidean Distance | 两个向量之间的直线距离 |
| 点积 | Dot Product | 考虑方向和长度的向量运算 |
| MTEB | Massive Text Embedding Benchmark | Embedding 模型评测排行榜 |
| 上下文窗口 | Context Window | 模型一次能处理的最大 Token 数 |